Pozicioniranje, ne sreča: kako stock iskanje metapodatke spremeni v klike in prodajo
Stock agencije razvrščajo po vedenju kupcev, ne le po ključnih besedah. Pot od ključne besede do prodaje, s formulami, viri in številkami s 635 fotografij.
Ključne ugotovitve
- Agencije vašo datoteko uvrstijo glede na to, kaj kupci z njo naredijo, ne glede na to, koliko datotek naložite. Klik ali nakup licence jo dvigne; rezultat, na katerega nihče ne klikne, zdrsne navzdol.
- Kadri iz serije z enakim naslovom in enakimi ključnimi besedami tekmujejo med seboj za ista dve ali tri iskanja. Skupna naj bo tema, ne seznam.
- Natančnost premaga pokritost. Kader, namenjen enemu konkretnemu kupcu, dobi klik; na široko razpršene ključne besede prinesejo prikaze, na katere nihče ne klikne, to pa vam zniža položaj.
Stock trg je zasičen z enakimi motivi, pa vendar večina portfeljev naših strank še vedno prodaja. Oboje velja hkrati, razlog pa je v nečem, česar večina avtorjev nikoli ne pogleda: kje datoteka stoji v iskanju in kaj se z njo zgodi, ko gre prvi kupec mimo nje.
To je dolga analiza. Gre skozi celotno verigo, od ključne besede do položaja, od položaja do klika in od klika do prodaje, ter navede, kaj posamezna agencija dokumentira, kaj je patentirano, kaj izmerjeno in kaj je mit. Če vas zanimajo samo pravila, skočite na kontrolni seznam na koncu.
Kaj je skupno iskanju pri vseh agencijah
Vsaka večja agencija iskanje izvede v dveh fazah. Najprej besedilo izbere kandidate: vaše ključne besede, vaš naslov ter pri agencijah Getty Images in iStock izraz iz nadzorovanega besednjaka, v katerega je bila preslikana vaša ključna beseda. Datoteka, ki se ne ujema s poizvedbo, za to poizvedbo ne obstaja. Nato vedenje kandidate razvrsti: prenosi, kliki, povečave, starost datoteke in vse pogosteje ocena modela, kako dobro bi se slika lahko prodajala. V tej drugi fazi se odloča o prodaji in te faze avtorji ne vidijo.
Načelo je povsod enako, izvedba pa ne, in razlike so pomembne, ko načrtujete serijo. Spodaj je zbrano, kar je posamezna agencija do oktobra 2026 dejansko objavila v pisni obliki, v patentu ali v API-ju za kupce.
| Agencija | Kaj je dokumentirano | Kje se ocenjuje vedenje | Vrsta vira |
|---|---|---|---|
| Shutterstock | Privzeto razvrščanje je po priljubljenosti; razvrščanje po ustreznosti »upošteva starost vsebine in priljubljenost«. Strani pomoči kot dejavnika navajajo prenose in starost datoteke ter pravijo, da se položaji z A/B-testi nenehno spreminjajo. | Patenti opisujejo oceno vedenja kupcev za vsako ključno besedo na vsaki sliki, sestavljeno iz nakupov, klikov, dodajanj v lightbox in predogledov ob premiku miške nad sliko, poleg tega pa še iz dejavnosti na slikah istega avtorja ali z istega fotografiranja. Nove datoteke dobijo napovedano oceno tržnega potenciala na podlagi pikslov. | Dokumentacija API-ja in pomoč (uradno); patenti US 10,409,822, US 11,360,927, US 11,216,506 (opisujejo metodo, ni potrjeno, da se dejansko uporablja) |
| Adobe Stock | Največjo težo ima prvih 10 ključnih besed; naslovi se upoštevajo pri iskanju in postanejo URL strani; najnovejša in najpogosteje licencirana vsebina je najbolj vidna; vsebina, ki se prikazuje, a je nihče ne licencira, velja za slabo uspešno in sčasoma izgublja vidnost; podobne datoteke je treba oddati v razmiku tedna ali dveh, da ne tekmujejo med seboj. | Po datoteki. Sprožilec, ki ga navaja Adobe, je licenca, ne klik. Avtorji ne vidijo ogledov. | Pomoč za avtorje in vodnik Mastering Metadata iz leta 2023 (uradno) |
| Getty / iStock | Ključne besede se preslikajo v nadzorovani besednjak; nepreslikana ključna beseda se ne uporabi; sinonime, prevode in širše izraze doda sistem. Privzeto razvrščanje je Best match (najboljše ujemanje). Uteži za razvrščanje niso objavljene. | Ni dokumentirano. Avtorji, ki se s tem ukvarjajo poklicno, opisujejo enak mehanizem kot pri drugih agencijah: datoteka, ki se prikazuje pri neki poizvedbi, a nanjo nihče ne klikne, zdrsne nazaj. | Smernice za avtorje (uradno) in izkušnje iz prakse |
| Alamy | Rezultati so razvrščeni po skupni oceni ustreznosti in AlamyRank. Ogled, ki ga kupec prezre, uvrstitev nekoliko zniža, klik jo zviša bolj, nakup še bolj. Nepomembne oznake »lahko v prihodnje škodijo vaši uvrstitvi«. Deset supertagov dobi dodatno prednost. Vrstni red ključnih besed ni pomemben. | Po psevdonimu, ne po sliki. Alamy je edina agencija, ki avtorjem pokaže oglede, povečave in CTR za vsak iskalni izraz. | Opis ob zagonu storitve leta 2006, pomoč in blog za avtorje, spletni seminar julija 2024 (uradno) |
| Pond5 | »Ustrezne ključne besede imajo v našem iskalnem algoritmu najpomembnejšo vlogo«; spam »bo vaši vidnosti le škodoval«. | Ni dokumentirano. | Pogosta vprašanja za avtorje (uradno) |
Izstopata dve stvari. Nihče ne objavi formule in nihče nima enotne »ocene kakovosti«, ki bi jo lahko prebrali na nadzorni plošči. Obstaja pa razmerje med odzivom kupcev in izpostavljenostjo, ki se računa na različnih ravneh: na Shutterstocku po ključni besedi in sliki, pri Adobe Stocku po datoteki, pri agenciji Alamy po psevdonimu. Ko ta članek govori o »oceni«, misli na to razmerje, kjer koli ga agencija vodi.
Veriga, zapisana kot ena formula
Vzemite eno datoteko in eno agencijo v obdobju enega leta. Pričakovana prodaja te datoteke je vsota po vseh poizvedbah, ki jih vpišejo kupci:
E[prodaja] = Σ po poizvedbah q:
             V(q) · P(kandidat | q) · P(viden | položaj) · P(klik | viden) · P(licenca | klik)
- V(q) je število kupcev, ki izvedejo to poizvedbo. Nanj ne vplivate; izberete pa, za katere poizvedbe se potegujete.
- P(kandidat | q) je 0 ali 1. O njem odločajo vaše ključne besede, naslov in preslikava v besednjak. To je edini dejavnik, ki ga metapodatki v celoti nadzorujejo.
- P(viden | položaj) je verjetnost, da se kupec pomakne dovolj daleč, da vidi sličico. O njej odloča položaj, ta pa je rezultat razvrščanja agencije.
- P(klik | viden) je razmerje klikov (CTR). Večino določi sličica, skupaj s tem, kako dobro se slika ujema s tem, kar je kupec s poizvedbo mislil.
- P(licenca | klik) je konverzija. O njej odloča vsebina: uporabnost v postavitvi, pristnost, orientacija, prostor za besedilo.
Metapodatki so na začetku verige in na vsak poznejši dejavnik vplivajo le posredno, prek prvih dveh. Zato je lahko isti seznam ključnih besed na eni datoteki vreden veliko, na drugi pa nič: poznejši dejavniki se množijo in ničla kjer koli izniči celoten zmnožek.
Druga stvar, ki jo pokaže formula, je, od kod pride vsota. Poizvedbe so kratke. V oceni na podlagi podatkov o klikih (clickstream) za sto najpogostejših poizvedb na Shutterstocku ima 80 % poizvedb eno ali dve besedi, po štetju Roberta Kneschkeja pa ima okoli 80 % poizvedb kupcev tri besede ali manj. Ena poizvedba zato preizkusi dve ali tri od vaših 30 do 50 ključnih besed. V vsoti prevladuje peščica ključnih besed, ki se ujemajo z resničnimi poizvedbami na položaju, do katerega kupec pride. Po Kneschkejevih podatkih o lastnem portfelju na Shutterstocku prodajo posamezne slike dejansko prinese tri do šest ključnih besed.
1. korak: kandidatura in začetni položaj
Nova datoteka nima zgodovine vedenja. V prvih tednih ima razvrščanje na voljo samo tri stvari: kako dobro se besedilo ujema s poizvedbo, kako nova je datoteka ter na Shutterstocku tudi to, kaj napovedujejo piksli. To je edino obdobje, v katerem metapodatki sami premikajo položaj, in je kratko.
Kaj lahko besedilo naredi ob objavi, se razlikuje od agencije do agencije:
- Adobe Stock največjo težo da prvim 10 ključnim besedam in bere naslov. Beseda, ki je v naslovu in med prvimi 10, se v iskanju še dodatno dvigne. Sprememba vrstnega reda ne stane skoraj nič in se v iskanju pokaže v nekaj urah; en avtor je izmeril, da se je datoteka približno štiri ure po spremembi vrstnega reda premaknila z mesta zunaj prve strani na sredino prve strani.
- Alamy bere opis (caption) kot poved, 10 supertagom (Supertags, oznake s prednostjo) pa da dodatno prednost. V testu enega avtorja z imenom redke rastline je bila datoteka na 288. mestu, ko je bil izraz samo med oznakami, na 193., ko je bil supertag, in na 69., ko je bil v opisu in hkrati supertag. Vrstni red znotraj seznama ni pomemben.
- Getty Images in iStock vsako ključno besedo preslikata v vozlišče besednjaka. Ključna beseda, ki ji niste določili pomena, se zavrže. Vrstni red ni več pomemben; pred leti je bil.
- Shutterstock ne objavlja nobenega pravila o vrstnem redu, analiza njegovih 10.472 najbolj priljubljenih slik pa ni našla nobenega znaka, da bi vrstni red pomagal.
Začetni položaj je nato odvisen od ene številke, na katero lahko vplivate: koliko drugih datotek se ujema z isto poizvedbo. Pri nevtralnem razvrščanju kupec novo datoteko vidi približno takrat, ko njegova globina listanja D doseže njen položaj med N datotekami, ki se ujemajo s poizvedbo:
P(viden ob objavi | q) ≈ min(1, D / N_q)
Kupci pri eni nalogi pregledajo od nekaj sto do približno dveh tisoč sličic (viri so v naslednjem razdelku). Pri D = 2.000 je za poizvedbo, kot je »background« (ozadje; primeri so v angleščini, ker agencije zahtevajo angleške metapodatke), ki na Shutterstocku vrne 222 milijonov datotek, verjetnost, da kupec novo datoteko vidi, približno 0,00001. Pri poizvedbi, ki vrne 793 datotek, je 1. To je mehanizem za tem, čemur smo v enem od prejšnjih člankov rekli teža ključne besede: vrednost besede za datoteko je blizu logaritmu tega, kako redka je beseda v zbirki, ker redkost odloča, ali bo kdo do datoteke sploh prišel.
teža(k) = ln( vse datoteke ÷ datoteke s ključno besedo k )
Za serijo to pomeni dvoje. Prvič, splošni, najbolj iskani izrazi (head terms) niso mesto, kjer bodo novo datoteko opazili, karkoli z njimi naredite. Drugič, »kategorija«, v katero umestite datoteko, ni spustni seznam kategorij v obrazcu za nalaganje, katerega teže ne dokumentira nobena agencija. To je nabor poizvedb, prek katerih kupec do datoteke dejansko lahko pride. Pozicioniranje pomeni, da ta nabor izberete premišljeno, po en nabor za vsako serijo, nato pa vsakemu kadru v njem daste svoj kot.
2. korak: položaj odloča, kdo bo viden
Nobena agencija ne objavi krivulje klikov za svojo mrežo rezultatov, zato je treba obliko vzeti iz sistemov, ki jo objavljajo. V organskih rezultatih Googlovega iskanja prvi rezultat dobi okoli 27,6 % klikov, približno desetkrat več kot deseti. Na Amazonu prvi izdelek dobi 35 %, drugi 17 %, tretji 12 %, deseti 3,5 %. Sledenje pogledu v laboratorijskih študijah kaže pristranskost zaupanja: uporabniki kliknejo prvi rezultat, tudi ko je drugi ustreznejši, in ko so raziskovalci na skrivaj obrnili vrstni red, se je povprečni položaj klika premaknil le z 2,7 na 4,0.
Pri mreži slik je upad blažji kot pri seznamu, a vseeno obstaja. V študiji dnevniških zapisov 100.000 sej iskanja slik je pozornost po položajih v mreži upadala počasneje kot pri spletnih rezultatih, z izmerjenim upadom 1,06 na korak v primerjavi z 1,48, in z nagnjenostjo k sredini vsake vrstice. Ista raziskava je pokazala, da se 62 % sej iskanja slik konča brez enega samega klika in da se uporabniki z miško nad sliko ustavijo približno dvajsetkrat pogosteje, kot nanjo kliknejo. Stock kupec, ki pregleduje mrežo, primerja, ne izbira.
Kako daleč kupci listajo, je številka, ki šteje za zgornjo formulo, in redki podatki, ki jih imamo, se ujemajo:
| Vir | Globina |
|---|---|
| Direktor agencije Alamy, 2006 | kupci pregledajo okoli 2.000 slik na nakup |
| Alamy Measures, poslovna iskanja, 2017 | v povprečju 546 ogledov na kupca, ki je našel, kar je iskal |
| Jim Pickerell o istih podatkih | večina kupcev neha pri približno 500 sličicah |
| Shutterstock API | število rezultatov je omejeno na 2.000 na poizvedbo |
| Adobe Stock, inženirska ekipa, 2019 | stranke »redko listajo zelo daleč« |
P(viden | položaj) je torej blizu 1 v prvih nekaj vrsticah, skozi prve strani upada in je blizu 0 po prvih 1.000 do 2.000 rezultatih. Za splošni izraz je to zid; za nišni izraz je zid dlje od števila datotek, ki se ujemajo s poizvedbo, in kupec vidi vsakega kandidata.
3. korak: klik je glas, preskočen prikaz pa tudi
To je korak, ki ga večina avtorjev še nikoli ni videla zapisanega, zato ga navajamo za vsako agencijo posebej.
Agencija Alamy je to zapisala že ob zagonu, leta 2006: slike, ki si jih kupci ogledajo, a jih prezrejo, se v uvrstitvi nekoliko spustijo, slike, na katere kliknejo, se dvignejo bolj, nakup pa jih dvigne najbolj. Ta uvrstitev se vodi po psevdonimu, na podlagi približno zadnjih devetih do desetih mesecev dejavnosti kupcev, pomoč za avtorje pa še vedno pravi, da lahko nepomembne oznake škodijo vaši uvrstitvi. Adobe to pove v vodniku za metapodatke iz leta 2023: datoteka, ki se vedno znova pojavlja v rezultatih, a je nihče ne licencira, velja za slabo uspešno in sčasoma izgublja vidnost. Shutterstock tega na straneh pomoči ne pove, njegovi patenti pa opisujejo oceno vedenja za vsako ključno besedo na vsaki sliki ter naučen model razvrščanja, ki datoteke, prikazane brez odziva, uporablja kot negativne primere. Getty Images in iStock ne objavljata ničesar, dva avtorja, ki se s tem ukvarjata poklicno, pa iz izkušenj opisujeta isto: datoteka, ki se prikazuje pri neki poizvedbi, a nanjo nihče ne klikne, pri tej poizvedbi zdrsne nazaj.
Alamy je edina agencija, pri kateri lahko to spremljate, ker prikazuje oglede, povečave (ko kupec odpre povečan prikaz slike) in razmerje med njimi. Definicija je preprosta:
CTR = povečave ÷ ogledi × 100
Povprečje za celotno zbirko se že desetletje giblje med 0,5 in 0,6. Štiri ali pet povečav ustreza eni prodaji, približno četrtina prodaj pa se zgodi brez ene same povečave. En izračunan primer iz poročila Alamy Measures: izraz »business« (posel) je v celotni zbirki prinesel 49.368 ogledov, 140 povečav in 4 prodaje, CTR 0,28. Izraz je izjemno pogost, skoraj nihče, ki ga je vpisal, pa ni kliknil ničesar.
Zdaj pa aritmetika, zaradi katere je napačna ključna beseda draga. CTR datoteke je vsota njenih klikov, deljena z vsoto njenih prikazov pri vseh ključnih besedah, ki jih ima:
CTR_datoteka = ( Σ kliki_k ) ÷ ( Σ prikazi_k )
Dodajte eno ključno besedo, ki je priljubljena, a ne opisuje tega, kar je na sliki. Prinese i_x prikazov in, ker se sličica ne ujema s poizvedbo, nobenega klika:
CTR_novi = CTR_datoteka × I ÷ ( I + i_x )
pri čemer je I število prikazov, ki jih je datoteka imela prej. Datoteka s 1.000 prikazi in 6 povečavami ima CTR 0,6. Ena široka ključna beseda, ki doda 2.000 prikazov brez klika, ga spusti na 0,2, ne da bi se spremenil en sam piksel. Pri agenciji Alamy ta številka vpliva na uvrstitev vseh drugih datotek pod istim psevdonimom. Na Shutterstocku po patentu škoda ostane pri tej ključni besedi, zato tam široka ključna beseda stane manj kot pri agenciji Alamy. Pri Adobe Stocku je sprožilec licenca, zato mora biti datoteka prikazana in preskočena, preden se sploh kaj zgodi.
Agencije ne ocenjujejo surovega CTR-ja. Etsy, edina spletna tržnica, ki svojo metodo dokumentira v celoti, odziv kupcev prilagodi glede na to, kje je bil oglas prikazan, Google Ads pa razmerje klikov ključne besede primerja z razmerjem drugih oglaševalcev na istem položaju v zadnjih 90 dneh. Stock agencije, ki svoje razvrščanje sploh opisujejo, opisujejo nekaj podobnega:
ocena_{t+1} = ocena_t + α · ( kliki − pričakovani_kliki(položaj) )
Klik iz 40. vrstice je vreden več kot klik iz 1. vrstice, ker se jih tam pričakuje manj. Prikaz brez klika v 1. vrstici stane več kot prikaz v 40. vrstici, iz istega razloga. V tem je ves argument za ozko pozicioniranje: želite, da vaši prikazi prihajajo iz poizvedb, pri katerih je sličica očiten odgovor, ne iz poizvedb, pri katerih je ena od desetih milijonov.
4. korak: zanka se sklene
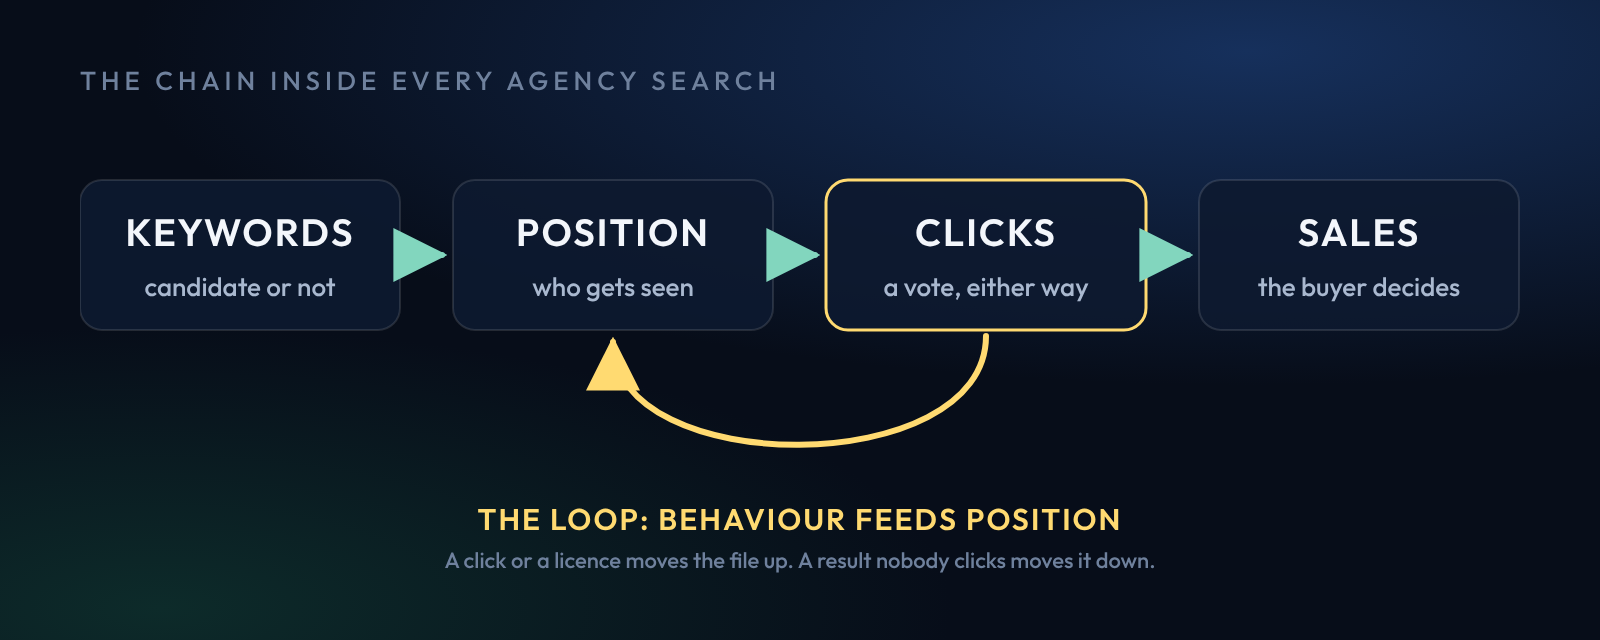
Vedenje vpliva na položaj. Klik ali nakup licence datoteko dvigne; rezultat, na katerega nihče ne klikne, zdrsne navzdol.
Ko vedenje vpliva na položaj in položaj na vedenje, ima sistem povratno zanko, zanke pa uspeh zberejo na peščici datotek. Shutterstock v svoji patentni prijavi sam zapiše, da razvrščanje po priljubljenosti »diskriminira nove slike« in avtorje odvrača. Inženirska ekipa podjetja Adobe je leta 2019 zapisala, da je vrh rezultatov iz dneva v dan pokazal »malo razlik«, zato je dodala model, ki blaži pristranskost položaja. Najčistejša meritev tega, kaj taka zanka naredi s trgom, je še vedno eksperiment MusicLab: 14.000 udeležencev, 48 neznanih pesmi, osem vzporednih svetov. V vsakem svetu, kjer so ljudje lahko videli, kaj so izbrali drugi, so zmagovalci zmagali z večjo razliko, katera pesem bo zmagala, pa je postalo deloma nepredvidljivo. Pesem, ki je bila po kakovosti 26., je v enem svetu končala na prvem mestu, v drugem pa na 40.
Agencije to vedo in ohranjajo odprte kanale za datoteke brez zgodovine: Adobe Stock ima načina razvrščanja Undiscovered in Fresh (neodkrito in sveže), Shutterstock filter za neodkrito vsebino za datoteke, mlajše od približno 90 dni, in oceno tržnega potenciala na podlagi pikslov, Alamy pa rezultate premeša zaradi raznolikosti. Zaradi teh kanalov se stara datoteka včasih proda, čeprav na njej ni nihče ničesar spremenil. Koristijo pa le datoteki, ki je pravilno opisana že ob prvem prikazu.
Zanka je počasna, in to počasnejša, kot predvideva večina nasvetov. Agencija Alamy je leta 2015 avtorjem povedala, da se uvrstitev preračuna približno vsakih 100 dni na podlagi podatkov za 300 dni in da nov psevdonim začne pri mediani. Adobe pravi »sčasoma« in ne navede številke. Patenti Shutterstocka kot primer navajajo vsakodnevno ponovno učenje modela in 30-dnevna obdobja. Kar zadeva prodajo, je avtor, ki je januarja 2026 naložil okoli 800 sprejetih datotek, poročal, da so prve prodaje iz njih prišle skoraj dva meseca pozneje in da je po treh mesecih zaslužil 55 dolarjev. Priljubljeno pravilo »30 dni na Adobe Stocku, 90 na Shutterstocku« je mit, ki je nastal iz primerov v patentih; nobena agencija ni objavila, kako dolgo traja začetno obdobje.
Za načrtovanje ta zamik pomeni tri stvari. Metapodatki morajo biti dokončani pred oddajo, ne pa krpani pozneje, ker prvih prikazov ne razredči nobena zgodovina. Datoteka, ki ji začetek spodleti, si le redko opomore samo s spremembo ključnih besed; dokumentirana primera okrevanja sta sprememba vrstnega reda na Adobe Stocku, ki je datoteko premaknila v nekaj urah, in psevdonim pri agenciji Alamy, pri katerem je CTR za okrevanje potreboval približno leto dni. Slaba prva serija pod enim psevdonimom pri agenciji Alamy pa s seboj potegne tudi naslednjo, ker je uvrstitev skupna.
Zakaj pozicioniramo serijo, ne posamezne fotografije
Kupec ne kupi fotografije, ki se je v iskanju dobro uvrstila. Klikne eno sličico, pride na stran z nizom podobnih slik in drugimi deli istega avtorja ter izbere kader, ki ustreza njegovi postavitvi. Orientacija, prostor za besedilo, kam gleda oseba, koliko mize se vidi: odločitev med kadri je njegova in jo sprejme po iskanju. Naša naloga je, da kupca sploh pripeljemo do serije.
Agencije pri tem pomagajo bolj, kot priznavajo. Patent Shutterstocka o vedenju kupcev združuje dejavnost na slikah istega avtorja ali z istega fotografiranja, zato klik na en kader koristi tudi sorodnim kadrom. Adobe avtorjem svetuje, naj podobne datoteke oddajo v razmiku tedna ali dveh, da ne bi tekmovale med seboj, kar je isti mehanizem, gledan z druge strani. To se vidi tudi v praksi: že omenjeni avtor, ki je leta 2026 naložil 800 novih datotek s koktajli, je poročal, da so se fotografije, ki jih že leta ni prodal, po objavi nove serije znova začele prodajati, in o rasti celotnega zaslužka za 40 %, za katero je previdno dodal, da je morda naključje, ki ga ne more izključiti.
Past je v tem, da »serijo« razumete kot »enake metapodatke«. Adobe enake naslove in ključne besede na podobnih datotekah navaja kot znak podobne vsebine, serija z enim skupnim seznamom pa je serija, ki tekmuje sama s seboj za ista dve ali tri iskanja. Izmerili smo, kaj vsebuje resnična serija. Jutranja rutina na balkonu, 39 kadrov, ena mapa: 79 različnih ključnih besed, ki držijo, povprečno 25,5 na kader, in samo 8, ki držijo za vsak kader. Degustacija vina s 188 kadri: 197 različnih ključnih besed, 24,9 na kader. Pokritost serije, torej število različnih poizvedb, za katere je serija lahko kandidat, je velikost unije njenih naborov ključnih besed:
pokritost(serija) = | K_1 ∪ K_2 ∪ … ∪ K_n |
S prekopiranimi metapodatki se ta unija skrči na en seznam, okoli 25 besed. S kotom kupca za vsak kader serija z balkona pokrije 79, kar je več kot trikrat več vstopnih točk za istih 39 slik, in vsak kader je očiten odgovor za svojih nekaj poizvedb, namesto da bi bil eden od 39 enakih odgovorov na iste poizvedbe. To mislimo s pozicioniranjem: ena tema na serijo, izbrana za iskalno območje, v katerem kupec do serije dejansko lahko pride, in en kot na kader znotraj njega. Serija pripelje kupca; kader dobi klik; kupec opravi nakup.
Kaj kažejo številke naših strank
Ozadje je trg, ki je zrasel za velikostni red, povpraševanje pa ne. Shutterstock je leta 2015 poročal o približno 70 milijonih slik, v začetku leta 2024 pa o 888 milijonih datotek; plačani prenosi so pri njem padli s 47,7 milijona v zadnjem četrtletju 2019 na 35 milijonov v prvem četrtletju 2024. Sredi leta 2026 je imela agencija Getty Images 625 milijonov slik in 39 milijonov videoposnetkov, plačani prenosi pa so bili za 2,8 % nižji kot leto prej. Neodvisna štetja ocenjujejo, da je delež vsebin, ustvarjenih z umetno inteligenco, na Adobe Stocku blizu polovice. Dolgoletni avtor, ki objavlja svoje številke, je leta 2026 prodal 48 % manj datotek kot leta 2019, čeprav je njegov portfelj medtem zrasel na več kot 45.000 datotek. Isti motivi, več datotek, povpraševanje, ki stoji na mestu: tako je zasičenost videti v številkah.
V takih razmerah spremljamo nalaganja, prenose in prodajo avtorjev, katerih serije obdelujemo. Med valom umetne inteligence v letih 2024 do 2026 večina teh portfeljev ni izgubila prodaje. Prav tako niso rasli sorazmerno s številom dodanih datotek, kar je iskrena druga polovica stavka: zgolj večje število datotek ne prinaša več tudi večjega zaslužka. Najjasneje se to vidi na računu na iStocku in Getty Images, za katerega že leta pripravljamo ključne besede. Na njegovi nadzorni plošči ESP (portal za avtorje agencije Getty Images) so mesečni prenosi v prvem delu obdobja rasli, nato pa so se ustalili na približno enaki ravni, z enim plitvim upadom in okrevanjem, prihodki po vrsti izdelka pa so se v letih 2025 in 2026 gibali enako. Gre za en sam račun, zato njegovih skupnih zneskov ne navajamo; pomembno je, da drugi računi, ki jih spremljamo, kažejo enak vzorec, ne pa upada.
Da prodaja ostane na isti ravni, medtem ko trg okoli vas upada, sta potrebni dve stvari, in obe vidimo v vsakem portfelju, ki mu to uspe. Prva je kakovost tega, kar naložite, v stock pomenu besede: motiv, ki ga kupec potrebuje, posnet tako, da ga je mogoče uporabiti. Druga je pozicioniranje: serija, umeščena v iskalno območje, v katerem kupci pridejo do nje, in vsak kader z lastnim razlogom, da kupec klikne nanj. Metapodatki so drugi dejavnik. Prvega ne morejo nadomestiti.
Prvi dejavnik: vsebina, ki jo naložite
Najmočnejši dokaz, da o prodaji odloča vsebina, prihaja iz posameznih portfeljev, v katerih je način pisanja ključnih besed ves čas enak, spreminja se le motiv. Vzemimo portfelj Steva Heapa s 15.000 datotekami: ključne besede piše en sam človek, vedno po isti rutini. Njegova kategorija prometa je na Shutterstocku na enoto portfelja prinesla približno 2,2-krat več kot kategorija narave, delež datotek, ki niso nikoli zaslužile niti dolarja, pa je glede na kategorijo segal od manj kot 1 % do skoraj 13 %. Ključne besede ne morejo pojasniti šestkratne razlike pri istem človeku, ki jih piše. Prodaja je tudi zgoščena: Yuri Arcurs ocenjuje, da 10 % njegovega portfelja ustvari 90 % prodaje, 200 najboljših od Heapovih 14.000 datotek pa je leta 2019 prineslo polovico njegovega zaslužka s fotografijami. V vsakem objavljenem primeru zmaga koncept, kraj, poseben dostop ali trenutek, ne tehnika in ne seznam ključnih besed.
Kupci isto opisujejo s svoje strani. Naročnik Shutterstocka, ki je po vrsti pokazal, kaj je kupil za svoje podjetje za izlete, je izbiral glede na to, ali kader prikazuje točno določen dogodek, prepoznaven zorni kot, ležečo orientacijo, ki jo je potreboval za svoje sličice, in ali je prizor v hotelu videti resničen ali zrežiran. Fotografijo spomenika je izpustil, ker ga je lahko posnel sam, fotografijo policijskega avtomobila pa, ker na njem ni bilo oznak nobene policijske enote. Ključnih besed ni niti omenil. Agencija Getty Images je poročala, da je skoraj 70 % njenih prihodkov v letu 2024 prišlo iz ekskluzivne vsebine, kar govori o razlikovanju, ne o oznakah.
Za zgornjo verigo vsebina določa dva dejavnika, na katera metapodatki ne morejo vplivati: P(klik | viden), ker je sličica slika sama, in P(licenca | klik), ker o tem odloča, ali se slika prilega postavitvi. Serijo generičnih kadrov s popolnim pozicioniranjem kupci opazijo in preskočijo, preskok pa se zabeleži.
Drugi dejavnik: pozicioniranje pri posameznih agencijah
Načelo je eno, pravil, ki se jih morate držati, pa je več. To je tabela, po kateri delamo.
| Agencija | Ključne besede | Vrstni red | Naslov / opis | Kaj škoduje |
|---|---|---|---|---|
| Adobe Stock | do 49, priporočeno 15 do 35 | največjo težo ima prvih 10; besede iz naslova, ponovljene med prvimi 10, datoteko še dodatno dvignejo | po njem je mogoče iskati, postane URL, okoli 70 znakov | netočne ključne besede; enaki metapodatki na podobnih datotekah; podobne datoteke, oddane isti dan |
| Shutterstock | 7 do 50 | ni objavljenega pravila; v analizi 10.472 slik ni merljivega učinka | naslov z vsaj 5 besedami: »kdo« / »kaj« / »kje« / »zakaj« | ponavljajoči se ali nepomembni izrazi se preverjajo in lahko škodijo računu |
| Getty / iStock | preslikajo se v nadzorovani besednjak | ni pomemben | opis vsebuje izraze, ki jih v besednjaku ni | ključna beseda brez določenega pomena se tiho zavrže |
| Alamy | do 50 oznak, 10 supertagov; okoli 20 je dovolj | ni pomemben | opis je poved, po kateri je mogoče iskati; iskalnik besed ne pretvarja v osnovno obliko, zato sta ednina in množina različna izraza | nepomembne oznake znižajo CTR in uvrstitev celotnega psevdonima |
| Pond5 | 40 do 50 | ni objavljenega pravila | podroben opis | spam »bo vaši vidnosti le škodoval« |
Natančnost premaga pokritost. Vsaka ključna beseda je stava, da bo kupec, ki jo vpiše, kliknil prav to sličico.
Iz tega izhajajo tri pravila. Prvo je zgornje, agencije z dokumentiranim mehanizmom pa to stavo tudi obračunajo. Metapodatke dokončate pred oddajo, ker prikazi ob objavi določijo oceno. In serija ima skupno temo, ne pa skupnega seznama: kadri se razlikujejo po prvih desetih besedah, opisu in supertagih, tako da je vsak jasen odgovor na svojo poizvedbo, ne pa podvojen odgovor na skupno.
Kontrolni seznam
- Preden napišete ključne besede, določite iskalno območje serije: prek katerih poizvedb (in koliko datotek se z njimi ujema) lahko kupec dejansko pride do nove datoteke? Splošni izrazi to niso.
- Vsakemu kadru dajte svoj kot: drugačnih prvih deset ključnih besed na Adobe Stocku, drug opis in druge supertage pri agenciji Alamy, drug naslov povsod. Skupna naj bo tema, ne seznam.
- Metapodatke dokončajte pred oddajo. Prvi prikazi se ocenijo brez zgodovine, ki bi jih omilila.
- Odstranite vsako ključno besedo, ki bi prinesla prikaz brez klika. Točna beseda, ki je nihče ne išče, ne škodi; priljubljena beseda, katere obljube slika ne izpolni, je strošek.
- Pri agenciji Alamy eksperimente, uredniško (editorial) in generično gradivo hranite pod ločenim psevdonimom. Uvrstitev je skupna in počasi okreva.
- Na Adobe Stocku podobne kadre oddajte v razmiku tedna ali dveh. Na Shutterstocku datoteke z zgodovino nikoli ne izbrišite, da bi jo naložili znova; zgodovina se ne prenese.
- Merite to, kar meri veriga: položaj za pet ciljnih poizvedb 1., 30. in 90. dan; čas do prve prodaje za vsako datoteko; delež datotek z vsaj eno prodajo po 90, 180 in 365 dneh, za vsako serijo; pri agenciji Alamy CTR po psevdonimu in iskalne izraze z veliko ogledi in brez povečav, saj so to ključne besede, ki vam škodijo.
Pogosta vprašanja
Ali nizko razmerje klikov res zniža uvrstitev stock fotografije?
Pri agenciji Alamy da, po opisu same agencije: ogled, ki ga kupec prezre, uvrstitev nekoliko zniža, uvrstitev pa si delijo vse datoteke pod istim psevdonimom. Pri Adobe Stocku je dokumentirani sprožilec datoteka, ki se prikazuje, a je nihče ne licencira, in ki potem velja za slabo uspešno. Na Shutterstocku je mehanizem opisan v patentih, po ključni besedi in sliki, ne na straneh pomoči. Getty Images in iStock ne objavljata ničesar; izkušeni avtorji poročajo o enakem vedenju.
Ali obstaja ocena kakovosti, ki jo lahko vidim?
Ne. Nobena agencija ne prikazuje enotne ocene. Alamy prikazuje oglede, povečave in CTR, kar je najbližje vpogledu v mehanizem. Nadzorna plošča pri Adobe Stocku vas razvršča po prodaji, to pa ni uvrstitev v iskanju. Vse drugo morate sklepati iz tega, kje se pojavljajo vaše datoteke.
Koliko časa potrebuje nova datoteka, da najde svoj položaj?
Dlje, kot trdi večina nasvetov. Agencija Alamy je nekoč uvrstitev preračunavala približno vsakih 100 dni na podlagi podatkov za 300 dni. Adobe pravi »sčasoma«. Avtor, ki je objavil svoje številke, je prve prodaje iz serije z 800 datotekami dočakal skoraj dva meseca po nalaganju. Natančni številki »30 dni« in »90 dni«, ki krožita, izvirata iz primerov v patentih, ne iz objavljenih pravil.
Ali naj imajo kadri iz serije enake ključne besede?
Skupno naj imajo temo. Enaki seznami kadre silijo, da tekmujejo za ista dve ali tri iskanja, Adobe pa jih navaja kot znak podobne vsebine. V resnični seriji z 39 kadri smo našteli 79 ključnih besed, ki držijo, od katerih jih je samo 8 sodilo na vsak kader; preostalih 71 je vstopnih točk, ki jih skupni seznam zavrže.
Kako smo šteli
Številke o serijah izhajajo iz štirih fotografiranj, obdelanih v aplikaciji Stock ImageIQ oktobra 2026: degustacija vina (188 fotografij), spa na strešni terasi (199), prijatelji, ki doma igrajo videoigre (169), in jutranja rutina na balkonu (79, od tega 39 v zgornji seriji), skupaj 635 fotografij. Za teže ključnih besed smo uporabili naravni logaritem. Izjave agencij so vzete iz njihove pomoči za avtorje, blogov, dokumentacije API-ja in, pri Shutterstocku, patentnih prijav, ki opisujejo metode in ne potrjujejo, kaj se dejansko uporablja. Krivulje klikov in globina listanja izvirajo iz objavljenih študij spletnega iskanja, spletnih trgovin in iskanja slik ter iz podatkov, ki jih je objavila agencija Alamy; nobena agencija ne objavi krivulje klikov za svojo mrežo rezultatov. Opažanja o strankah so naša; formule so model dokumentiranega mehanizma, ne koda katere koli agencije. Nihče, niti mi, ni objavil nadzorovanega poskusa, ki bi izmeril, koliko sprememba ključnih besed premakne prodajo, in tudi ta članek ne trdi, da ga ima.
Viri (v angleščini): Shutterstock API: iskanje · Pomoč Shutterstock: kaj določa vrstni red v iskanju · Shutterstock, patent US 10,409,822 · Shutterstock, patent US 11,360,927 · Shutterstock, patent US 11,216,506 · Adobe Stock: nasveti za učinkovite naslove in ključne besede · Adobe Stock: vodnik Mastering Metadata, 2023 · Adobe Tech Blog: pristranskost položaja v iskanju Adobe Stock, 2019 · Alamy: opisi in oznake · Alamy, pogosta vprašanja za avtorje: opisi in ključne besede · Selling Stock: Alamy Measures, 2017 · iStock: vodnik po iskanju · Pond5: pogosta vprašanja za avtorje · Etsy Seller Handbook: kako deluje iskanje na Etsyju · Pomoč Google Ads: o oceni kakovosti · Xpiks: analiza 10.472 najbolj priljubljenih slik na Shutterstocku · Xpiks: 100 najpogostejših poizvedb na Shutterstocku · Backyard Silver: vrstni red ključnih besed na Adobe Stocku · Xpiks: najbolje prodajane kategorije · Xpiks: neprodane stock fotografije · Freakonomics: epizoda o stock fotografijah (Arcurs) · Getty Images: poročilo 10-K za leto 2024 · Salganik, Dodds in Watts, MusicLab, 2006 · Wollertz: 1.000 stock fotografij, 3 meseci · Blokhin Films: kako napisati ključne besede in naslove za stock vsebine · Luka Ažman: kako napisati ključne besede za stock fotografije · Nicole Glass: kupec na Shutterstocku pojasni, kaj kupuje.
Stock ImageIQ vsako serijo umesti v eno iskalno območje in vsakemu kadru da svoj kot, tako da serija pripelje kupca, vsak kader pa dobi klik. Preizkusite na naslednjem fotografiranju.
Preberite še: Teža ključnih besed: zakaj na stock agencijah zmagajo nišne besede · Iste ključne besede na vseh fotografijah? Vaša serija tekmuje sama s seboj